Quatre façons de compter le même texte
Les ordinateurs stockent le texte sous forme de nombres, et il existe plusieurs façons raisonnables de compter ces nombres. Applications et jeux en choisissent une — généralement sans vous le dire —, si bien qu’un même nom peut tenir à un endroit et être « trop long » ailleurs.
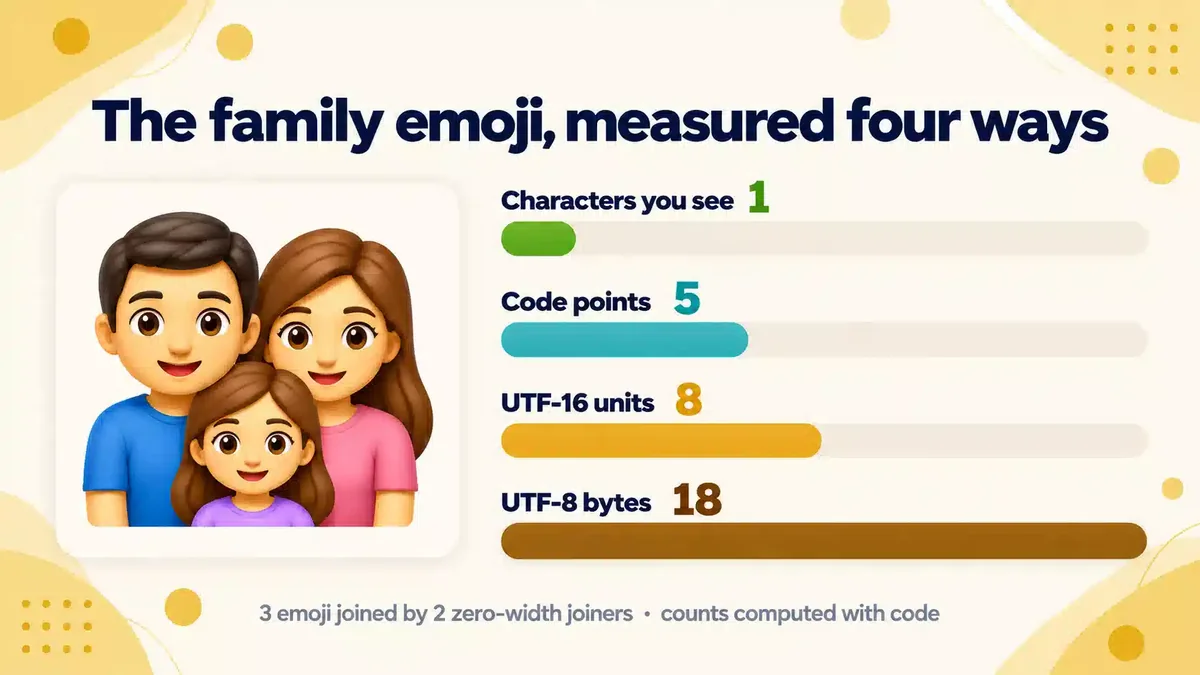
| Mesure | Ce qu’elle compte |
|---|---|
| Graphèmes (caractères visibles) | Ce qu’un lecteur perçoit comme un seul caractère, même s’il est construit à partir de plusieurs éléments. |
| Points de code | Chaque caractère Unicode séparément, y compris les liants invisibles et les signes combinants. |
| unités UTF-16 | L’unité de stockage utilisée dans JavaScript, Java, Windows et de nombreuses applications. Les caractères au-delà de U+FFFF en prennent deux. |
| Octets UTF-8 | La taille une fois stocké ou transmis en UTF-8, l’encodage habituel du web : de 1 à 4 octets par point de code. |
Exemples testés
Chaque nombre ci-dessous a été produit par du code, pas saisi à la main : les graphèmes avec Intl.Segmenter dans Node.js 22.22.2 (ICU 78.2, Unicode 17.0), les autres décomptes à partir du texte encodé, vérifiés en Python. Des versions logicielles différentes peuvent parfois diverger sur les limites de graphèmes pour les écritures complexes.
| Texte | Description | Graphèmes | Points de code | UTF-16 | Octets UTF-8 |
|---|---|---|---|---|---|
| Luna | Lettres latines simples | 4 | 4 | 4 | 4 |
| Zoë | ë en un seul caractère (U+00EB) | 3 | 3 | 3 | 4 |
| Zoë | e + tréma combinant (U+0308) | 3 | 4 | 4 | 5 |
| 𝓛𝓾𝓷𝓪 | Lettres cursives grasses (Mathematical Alphanumeric Symbols) | 4 | 4 | 8 | 16 |
| ꧁Luna꧂ | Nom dans un cadre de ponctuation javanaise | 6 | 6 | 6 | 10 |
| Luna🔥 | Nom + un emoji | 5 | 5 | 6 | 8 |
| 👍🏽 | Emoji + modificateur de couleur de peau | 1 | 2 | 4 | 8 |
| 🇯🇵 | Drapeau (deux lettres indicatrices régionales) | 1 | 2 | 4 | 8 |
| 👨👩👧 | Emoji famille (trois emojis reliés par des liants sans chasse) | 1 | 5 | 8 | 18 |
| ليلى | Lettres arabes | 4 | 4 | 4 | 8 |
Graphèmes : ce que vous voyez réellement
L’Unicode Standard Annex #29 définit les grappes de graphèmes étendues — les caractères tels que l’utilisateur les perçoit. Une lettre avec un accent combinant, un emoji avec une couleur de peau, un drapeau formé de deux lettres indicatrices régionales et un emoji famille relié par des liants sans chasse forment chacun un seul graphème.
À l’intérieur de l’emoji famille
| Point de code | Pseudo | UTF-16 | Octets |
|---|---|---|---|
| U+1F468 | Homme | 2 | 4 |
| U+200D | Zero Width Joiner | 1 | 3 |
| U+1F469 | Femme | 2 | 4 |
| U+200D | Zero Width Joiner | 1 | 3 |
| U+1F467 | Fille | 2 | 4 |
Points de code : les numéros Unicode
Un point de code est le numéro d’un caractère dans Unicode, écrit U+ suivi de chiffres hexadécimaux. « ë » peut s’écrire avec un seul point de code (U+00EB) ou avec « e » suivi de U+0308 COMBINING DIAERESIS. Les deux sont visuellement identiques — c’est pourquoi deux noms d’apparence identique peuvent se compter différemment, et pourquoi certaines applications normalisent d’abord le texte.
UTF-16 : pourquoi les lettres stylisées comptent double
UTF-16 stocke les points de code jusqu’à U+FFFF dans une unité de 16 bits et tout ce qui est au-dessus dans deux (une paire de substitution). Les lettres grasses, cursives et gothiques de NameFonts proviennent pour la plupart du bloc Mathematical Alphanumeric Symbols (U+1D400–U+1D7FF), et la plupart des emojis sont aussi au-delà de U+FFFF — chacun prend donc deux unités. Les neuf nouveaux emojis d’Unicode 18.0 ne font pas exception. En JavaScript, "𝓛".length vaut 2.
UTF-8 : les octets stockés et transmis
UTF-8 utilise 1 octet pour les lettres ASCII, 2 octets pour la plupart des lettres latines accentuées, le grec, le cyrillique, l’arabe et l’hébreu, 3 octets pour la plupart des autres caractères jusqu’à U+FFFF (dont le CJK et de nombreux symboles) et 4 octets au-delà. Les limites des bases de données et des réseaux sont souvent exprimées en octets.
Laquelle mon application utilise-t-elle ?
Nous n’indiquons pas de limites pour des applications ou des jeux précis : elles sont rarement documentées et elles changent. Un test rapide permet de savoir quelle unité une application compte :
- Tapez un nom simple jusqu’à la limite et notez le nombre.
- Remplacez une lettre par une lettre stylisée (par exemple depuis le générateur cursive).
- Si le nom compte maintenant un de plus, l’application compte les unités UTF-16 ; si le décompte reste identique, elle compte les graphèmes ou les points de code.
- Essayez « Zoë » écrit des deux façons (voir le tableau ci-dessus) pour distinguer les graphèmes des points de code.
Questions fréquentes
Pourquoi mon nom compte-t-il plus de caractères que ce que je vois ?
Certains caractères visibles sont composés de plusieurs points de code, et les caractères au-delà de U+FFFF utilisent deux unités UTF-16. Les applications qui comptent les points de code ou les unités UTF-16 annoncent un nombre plus élevé que ce que vous voyez.
Un graphème est-il la même chose qu’une lettre ?
Pas toujours. Un graphème, c’est ce qu’un lecteur perçoit comme un seul caractère. En écriture latine, c’est généralement une lettre, mais une séquence d’emojis ou une lettre avec des signes combinants forme aussi un seul graphème.
Sources
- Unicode Standard Annex #29: Unicode Text Segmentation — grappes de graphèmes étendues
- The Unicode Standard, Chapter 3 (Conformance): encoding forms — UTF-8, UTF-16 et points de code
- MDN: Intl.Segmenter — l’API utilisée pour compter les graphèmes
Collez votre propre nom pour voir les quatre décomptes, caractère par caractère.