Vier Arten, denselben Text zu zählen
Computer speichern Text als Zahlen, und es gibt mehr als eine sinnvolle Art, diese Zahlen zu zählen. Apps und Spiele wählen eine davon – meist ohne es dir zu sagen –, sodass derselbe Name an einer Stelle passt und an einer anderen „zu lang“ ist.
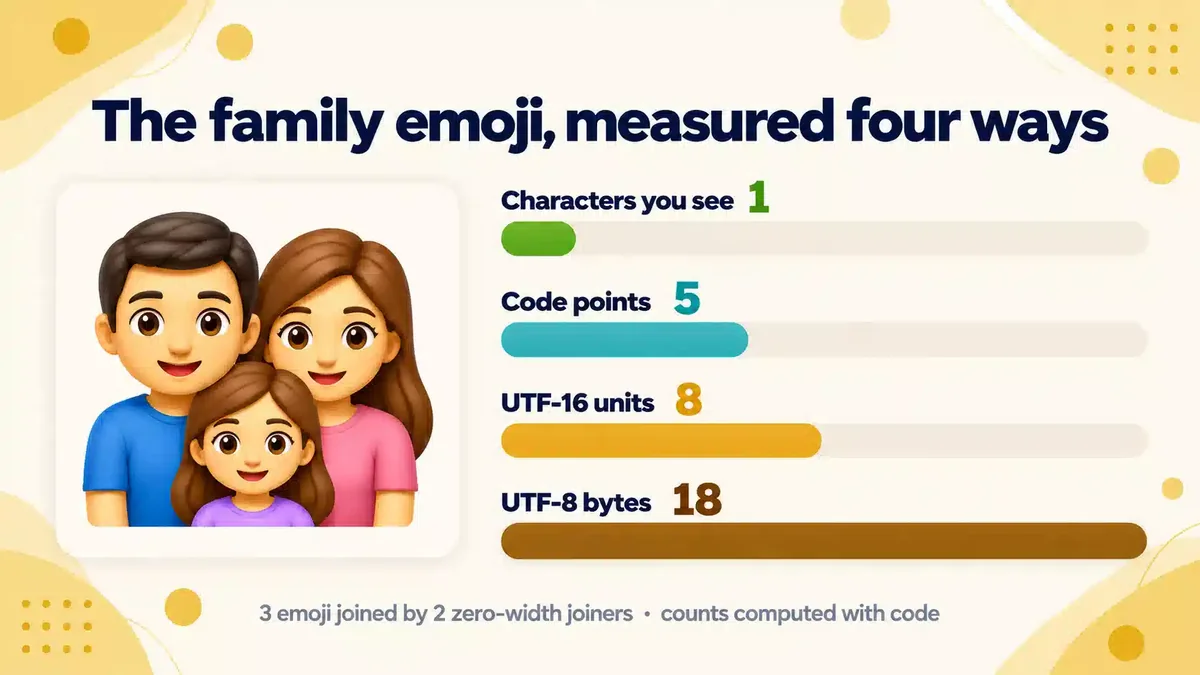
| Messgröße | Was gezählt wird |
|---|---|
| Grapheme (sichtbare Zeichen) | Was ein Leser als ein Zeichen wahrnimmt, auch wenn es aus mehreren Teilen besteht. |
| Codepunkte | Jedes Unicode-Zeichen einzeln, einschließlich unsichtbarer Verbinder und kombinierender Zeichen. |
| UTF-16-Einheiten | Die Speichereinheit in JavaScript, Java, Windows und vielen Apps. Zeichen oberhalb von U+FFFF belegen zwei. |
| UTF-8-Bytes | Die Größe beim Speichern oder Senden als UTF-8, der üblichen Kodierung im Web: 1 bis 4 Bytes pro Codepunkt. |
Getestete Beispiele
Jede Zahl unten wurde per Code erzeugt, nicht von Hand eingetippt: Grapheme mit Intl.Segmenter in Node.js 22.22.2 (ICU 78.2, Unicode 17.0), die übrigen Zählungen aus dem kodierten Text, gegengeprüft in Python. Verschiedene Softwareversionen können sich bei komplexen Schriften gelegentlich über Graphemgrenzen uneinig sein.
| Text | Was es ist | Grapheme | Codepunkte | UTF-16 | UTF-8-Bytes |
|---|---|---|---|---|---|
| Luna | Einfache lateinische Buchstaben | 4 | 4 | 4 | 4 |
| Zoë | ë als ein Zeichen (U+00EB) | 3 | 3 | 3 | 4 |
| Zoë | e + kombinierendes Trema (U+0308) | 3 | 4 | 4 | 5 |
| 𝓛𝓾𝓷𝓪 | Fette Schreibschrift-Buchstaben (Mathematical Alphanumeric Symbols) | 4 | 4 | 8 | 16 |
| ꧁Luna꧂ | Name in einem Rahmen aus javanischen Satzzeichen | 6 | 6 | 6 | 10 |
| Luna🔥 | Name + ein Emoji | 5 | 5 | 6 | 8 |
| 👍🏽 | Emoji + Hautton-Modifikator | 1 | 2 | 4 | 8 |
| 🇯🇵 | Flagge (zwei regionale Indikatorbuchstaben) | 1 | 2 | 4 | 8 |
| 👨👩👧 | Familien-Emoji (drei Emojis, verbunden durch Zero-Width Joiner) | 1 | 5 | 8 | 18 |
| ليلى | Arabische Buchstaben | 4 | 4 | 4 | 8 |
Grapheme: was du tatsächlich siehst
Unicode Standard Annex #29 definiert erweiterte Graphem-Cluster – die Zeichen, wie Nutzer sie wahrnehmen. Ein Buchstabe mit kombinierendem Akzent, ein Emoji mit Hautton, eine Flagge aus zwei regionalen Indikatorbuchstaben und ein mit Zero-Width Joinern verbundenes Familien-Emoji sind jeweils ein Graphem.
Im Inneren des Familien-Emojis
| Codepunkt | Name | UTF-16 | Bytes |
|---|---|---|---|
| U+1F468 | Mann | 2 | 4 |
| U+200D | Zero Width Joiner | 1 | 3 |
| U+1F469 | Frau | 2 | 4 |
| U+200D | Zero Width Joiner | 1 | 3 |
| U+1F467 | Mädchen | 2 | 4 |
Codepunkte: die Unicode-Nummern
Ein Codepunkt ist die Nummer eines Zeichens in Unicode, geschrieben als U+ gefolgt von Hexadezimalziffern. „ë“ lässt sich als ein Codepunkt (U+00EB) oder als „e“ plus U+0308 COMBINING DIAERESIS schreiben. Beides sieht gleich aus – deshalb können zwei gleich aussehende Namen unterschiedlich gezählt werden, und deshalb normalisieren manche Apps Text zuerst.
UTF-16: warum gestylte Buchstaben doppelt zählen
UTF-16 speichert Codepunkte bis U+FFFF in einer 16-Bit-Einheit und alles darüber in zweien (einem Surrogatpaar). Die fetten, Schreibschrift- und Frakturbuchstaben auf NameFonts stammen überwiegend aus dem Block Mathematical Alphanumeric Symbols (U+1D400–U+1D7FF), und die meisten Emojis liegen ebenfalls oberhalb von U+FFFF – jedes belegt also zwei Einheiten. Die neun neuen Emojis in Unicode 18.0 sind keine Ausnahme. In JavaScript ergibt "𝓛".length den Wert 2.
UTF-8: Bytes auf der Festplatte und im Netz
UTF-8 braucht 1 Byte für ASCII-Buchstaben, 2 Bytes für die meisten lateinischen Akzentbuchstaben, Griechisch, Kyrillisch, Arabisch und Hebräisch, 3 Bytes für die meisten anderen Zeichen bis U+FFFF (einschließlich CJK und vieler Symbole) und 4 Bytes darüber. Grenzen von Datenbanken und Netzwerken werden oft in Bytes angegeben.
Welche nutzt meine App?
Wir nennen keine Grenzen für bestimmte Apps oder Spiele: Sie sind selten dokumentiert und ändern sich. Mit einem kurzen Test findest du heraus, welche Einheit eine App zählt:
- Tippe einen einfachen Namen bis zum Limit und notiere die Zahl.
- Ersetze einen Buchstaben durch einen gestylten (zum Beispiel aus dem Schreibschrift-Generator).
- Zählt der Name jetzt eins mehr, zählt die App UTF-16-Einheiten; bleibt die Zahl gleich, zählt sie Grapheme oder Codepunkte.
- Probiere „Zoë“ in beiden Schreibweisen (aus der Tabelle oben), um Grapheme von Codepunkten zu unterscheiden.
Häufige Fragen
Warum zählt mein Name mehr Zeichen, als ich sehe?
Manche sichtbaren Zeichen bestehen aus mehreren Codepunkten, und Zeichen oberhalb von U+FFFF belegen zwei UTF-16-Einheiten. Apps, die Codepunkte oder UTF-16-Einheiten zählen, melden eine größere Zahl, als du siehst.
Ist ein Graphem dasselbe wie ein Buchstabe?
Nicht immer. Ein Graphem ist das, was ein Leser als ein Zeichen wahrnimmt. Bei lateinischem Text ist es meist ein Buchstabe, aber auch eine Emoji-Sequenz oder ein Buchstabe mit kombinierenden Zeichen ist ein Graphem.
Quellen
- Unicode Standard Annex #29: Unicode Text Segmentation – erweiterte Graphem-Cluster
- The Unicode Standard, Chapter 3 (Conformance): encoding forms – UTF-8, UTF-16 und Codepunkte
- MDN: Intl.Segmenter – die für die Graphemzählung verwendete API
Füge deinen eigenen Namen ein, um alle vier Zählungen Zeichen für Zeichen zu sehen.