Cuatro formas de contar el mismo texto
Los ordenadores guardan el texto como números, y hay más de una forma razonable de contarlos. Las apps y los juegos eligen una, normalmente sin decírtelo, así que el mismo nombre puede caber en un sitio y ser «demasiado largo» en otro.
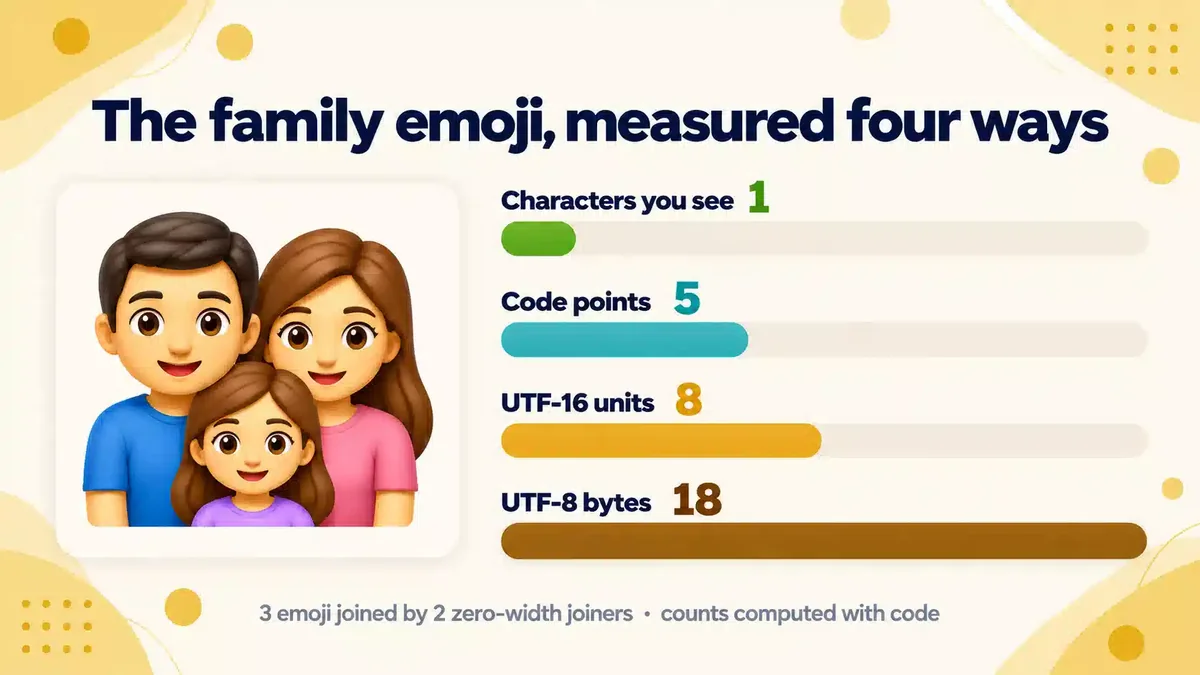
| Medida | Qué cuenta |
|---|---|
| Grafemas (caracteres que ves) | Lo que un lector percibe como un solo carácter, aunque esté formado por varias piezas. |
| Puntos de código | Cada carácter Unicode por separado, incluidas las uniones invisibles y las marcas combinables. |
| unidades UTF-16 | La unidad de almacenamiento que usan JavaScript, Java, Windows y muchas apps. Los caracteres por encima de U+FFFF ocupan dos. |
| Bytes UTF-8 | El tamaño al guardarse o enviarse como UTF-8, la codificación habitual de la web: de 1 a 4 bytes por punto de código. |
Ejemplos probados
Cada número de abajo lo generó código, no se escribió a mano: los grafemas con Intl.Segmenter en Node.js 22.22.2 (ICU 78.2, Unicode 17.0) y los demás recuentos a partir del texto codificado, contrastados en Python. Distintas versiones de software pueden discrepar a veces sobre los límites de grafemas en escrituras complejas.
| Texto | Qué es | Grafemas | Puntos de código | UTF-16 | Bytes UTF-8 |
|---|---|---|---|---|---|
| Luna | Letras latinas simples | 4 | 4 | 4 | 4 |
| Zoë | ë como un solo carácter (U+00EB) | 3 | 3 | 3 | 4 |
| Zoë | e + diéresis combinable (U+0308) | 3 | 4 | 4 | 5 |
| 𝓛𝓾𝓷𝓪 | Letras cursivas en negrita (Mathematical Alphanumeric Symbols) | 4 | 4 | 8 | 16 |
| ꧁Luna꧂ | Nombre en un marco de puntuación javanesa | 6 | 6 | 6 | 10 |
| Luna🔥 | Nombre + un emoji | 5 | 5 | 6 | 8 |
| 👍🏽 | Emoji + modificador de tono de piel | 1 | 2 | 4 | 8 |
| 🇯🇵 | Bandera (dos letras indicadoras regionales) | 1 | 2 | 4 | 8 |
| 👨👩👧 | Emoji de familia (tres emojis unidos por uniones de ancho cero) | 1 | 5 | 8 | 18 |
| ليلى | Letras árabes | 4 | 4 | 4 | 8 |
Grafemas: lo que realmente ves
El Unicode Standard Annex #29 define los clústeres de grafemas extendidos: los caracteres tal como los percibe el usuario. Una letra con un acento combinable, un emoji con tono de piel, una bandera formada por dos letras indicadoras regionales y un emoji de familia unido con uniones de ancho cero son, cada uno, un grafema.
Dentro del emoji de familia
| Punto de código | Nombre | UTF-16 | Bytes |
|---|---|---|---|
| U+1F468 | Hombre | 2 | 4 |
| U+200D | Zero Width Joiner | 1 | 3 |
| U+1F469 | Mujer | 2 | 4 |
| U+200D | Zero Width Joiner | 1 | 3 |
| U+1F467 | Niña | 2 | 4 |
Puntos de código: los números de Unicode
Un punto de código es el número de un carácter en Unicode, escrito como U+ seguido de dígitos hexadecimales. «ë» se puede escribir como un solo punto de código (U+00EB) o como «e» más U+0308 COMBINING DIAERESIS. Ambos se ven iguales; por eso dos nombres que parecen idénticos pueden contarse de forma distinta y por eso algunas apps normalizan antes el texto.
UTF-16: por qué las letras con estilo cuentan doble
UTF-16 guarda los puntos de código hasta U+FFFF en una unidad de 16 bits y todo lo que está por encima en dos (un par subrogado). Las letras en negrita, cursiva y góticas de NameFonts vienen sobre todo del bloque Mathematical Alphanumeric Symbols (U+1D400–U+1D7FF), y la mayoría de los emojis también están por encima de U+FFFF, así que cada uno ocupa dos unidades. Los nueve emojis nuevos de Unicode 18.0 no son una excepción. En JavaScript, "𝓛".length es 2.
UTF-8: los bytes en disco y en la red
UTF-8 usa 1 byte para las letras ASCII, 2 bytes para la mayoría de las letras latinas con tilde, el griego, el cirílico, el árabe y el hebreo, 3 bytes para la mayoría de los demás caracteres hasta U+FFFF (incluidos los CJK y muchos símbolos) y 4 bytes por encima. Los límites de bases de datos y redes suelen expresarse en bytes.
¿Cuál usa mi app?
No indicamos límites para apps o juegos concretos: rara vez están documentados y cambian. Con una prueba rápida puedes averiguar qué unidad cuenta una app:
- Escribe un nombre normal hasta el límite y anota el número.
- Sustituye una letra por una letra con estilo (por ejemplo, del generador de cursiva).
- Si el nombre cuenta ahora uno más, la app cuenta unidades UTF-16; si el recuento no cambia, cuenta grafemas o puntos de código.
- Prueba «Zoë» escrito de las dos formas (de la tabla de arriba) para distinguir grafemas de puntos de código.
Preguntas frecuentes
¿Por qué mi nombre cuenta más caracteres de los que veo?
Algunos caracteres visibles están formados por varios puntos de código, y los caracteres por encima de U+FFFF usan dos unidades UTF-16. Las apps que cuentan puntos de código o unidades UTF-16 dan un número mayor que lo que ves.
¿Un grafema es lo mismo que una letra?
No siempre. Un grafema es lo que un lector percibe como un solo carácter. En texto latino suele ser una letra, pero una secuencia de emojis o una letra con marcas combinables también es un grafema.
Fuentes
- Unicode Standard Annex #29: Unicode Text Segmentation — clústeres de grafemas extendidos
- The Unicode Standard, Chapter 3 (Conformance): encoding forms — UTF-8, UTF-16 y puntos de código
- MDN: Intl.Segmenter — la API usada para contar los grafemas
Pega tu propio nombre para ver los cuatro recuentos, carácter a carácter.